
「危ないことはAIが自分で判断して止める」——そんな時代が、少しずつ近づいてきています。
AI開発企業のAnthropic(アンソロピック)は、AIによるプログラミング支援ツール「Claude Code」の新しい安全機能を、2026年8月14日から標準搭載すると発表しました。
プログラミングをしない方には縁遠く感じるかもしれませんが、AIが「何を自分で判断し、何を人に確認するか」という線引きは、今後あらゆるAIサービスに広がっていく可能性がある動きです。
今回はその内容をご紹介します。
Claude Codeの「auto mode」とは
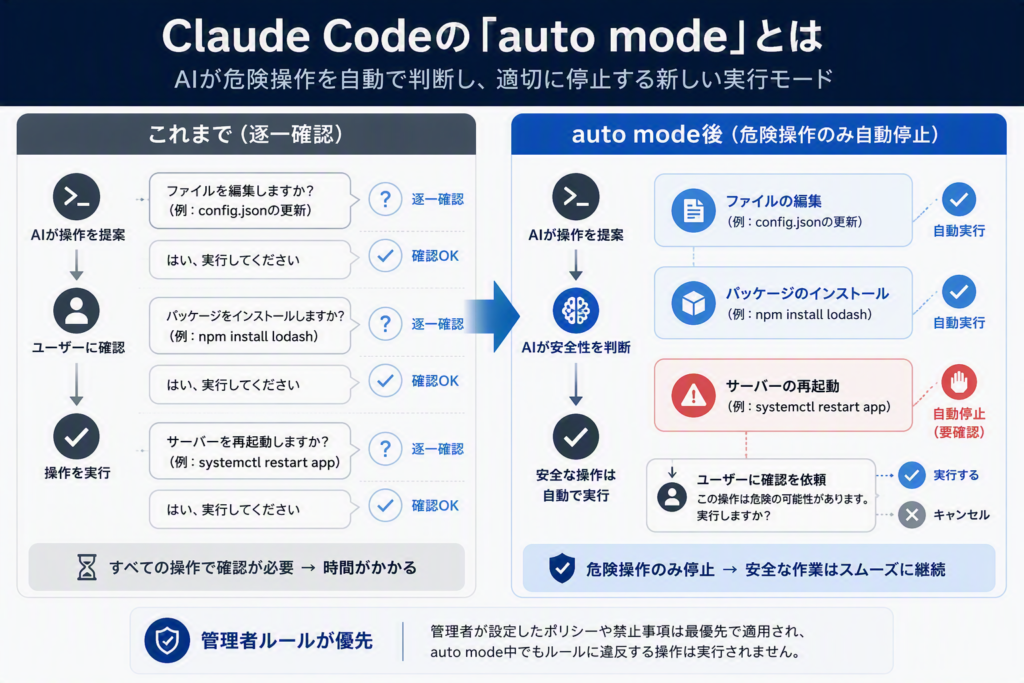
Claude Codeは、Anthropicが提供する、AIがプログラムのコードを書いたり操作したりするのを支援するツールです。今回発表された「auto mode」は、この中で「危険な操作をAIが自動的に見分けて止める」という新しい仕組みです。
これまでは、AIが何か操作をするたびに人間が逐一「実行してよいか」を確認する必要がありました。auto modeでは、通常の作業はAIの判断でそのまま進め、取り返しがつかない操作・破壊的な操作・想定外の範囲に影響する操作だけをAIが検知して自動的に停止する、という仕組みに変わります。なお、管理者があらかじめ「これは必ず確認して」「これは絶対にさせない」と設定したルールは、AIの自動判断よりも優先されます。
2026年8月14日から、Pro・Max・Teamプランの新しいセッションではこの機能が標準(既定)となります。
なぜ今、AIが「危険操作」を判断するのか
背景にあるのは、「確認作業が多すぎて、かえって見落としが増える」という課題です。
AIに何か作業を任せるたびに逐一「実行しますか?」と聞かれ続けると、人はだんだん内容を確認せずに「はい」を押すようになってしまいます。これは「承認疲れ」と呼ばれる現象です。
auto modeは、本当に危険な操作だけをAIが見極めて止めることで、この承認疲れを減らしつつ、安全性も保とうという狙いがあります。
公表された数値で見る効果
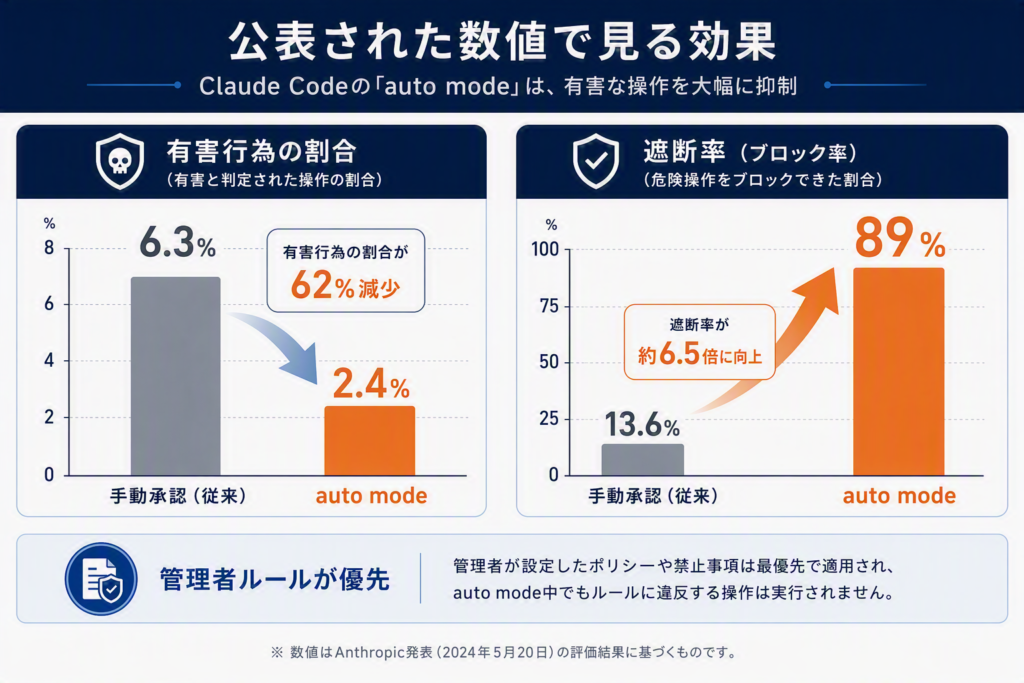
Anthropicが公表したデータによると、次のような結果が示されています。
| 指標 | 数値 |
|---|---|
| 権限確認の承認率(人による確認時) | 97% |
| テスターによる危険コマンドの遮断率 | 13.6% |
| auto modeによる危険操作の遮断率 | 89% |
| 手動承認セッションでの有害行為の割合 | 6.3% |
| auto modeセッションでの有害行為の割合 | 2.4% |
人が逐一確認していたときよりも、AIが自動で見分けたほうが危険な操作を止められている、という結果です。また、同じ操作が3回連続、または合計20回ブロックされると、自動的に人による確認モードに戻る仕組みも用意されており、AIに任せきりにならないような工夫もされています。
適用範囲と今後の展開
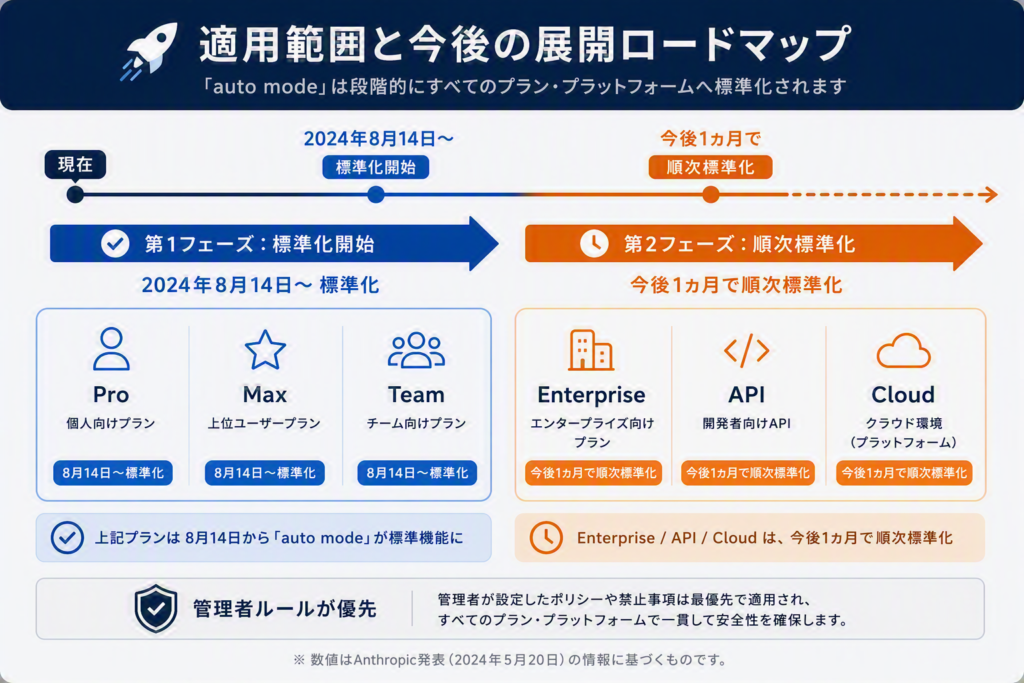
2026年8月14日時点で標準化されるのは、個人・チーム向けのPro・Max・Teamプランです。企業向けのEnterpriseプランやClaude API、各種クラウド経由の利用については、今のところ利用者が選んで有効にする形(オプトイン)が維持されますが、今後1カ月ほどかけて段階的に標準化される予定とされています。
Anthropicは、本番のシステムなど影響の大きい変更については「引き続き利用者自身による確認を推奨する」ともしており、AIに任せる部分と人が確認すべき部分の線引きは、今後も見直されていきそうです。
私たちの生活にどう関係するか
今回の発表は、プログラミングを行うClaude Codeというツールに関するものなので、直接使う機会がある方は限られるかもしれません。ただ、ここで起きている変化——「AIに何を任せ、何を人が確認するか」という線引きが少しずつAI側の判断に委ねられていく流れ——は、今後、文章作成や日常のスケジュール管理など、より身近なAIサービスにも広がっていく可能性があります。
ふだんChatGPTやClaude、Geminiなどを使っている方にとっても、「AIがどこまで自分で判断し、どこから人に確認を求めてくるのか」という感覚は、今後のAIサービス選びや使い方を考えるうえでのひとつの目安になりそうです。
まとめ
Anthropicが発表した「auto mode」は、AI自身が危険な操作を見分けて止める仕組みを取り入れた新機能です。承認疲れを減らしながら安全性も保つという狙いのもと、2026年8月14日からClaude Codeの主要プランで標準搭載されます。プログラミングとは縁のない方にも、「AIがどこまで自分で判断するようになるのか」という大きな流れを知っておくきっかけとして、注目しておきたい発表です。

